Репликация означает хранение копий одних и тех же данных на нескольких машинах, подключенных через сеть. Репликация может быть синхронной или асинхронной .
Для очень больших наборов данных или очень высокой пропускной способности запросов, этого недостаточно, нам нужно разбить данные на разделы. Это также известно как
- Преимущества
- Репликация главный-подчиненный
- Обработка сбоев подчиненного узла
- Обработка сбоев главного узла
- Общие сведения о журнале репликации
- Использование в лучшем случае
- Распространенные проблемы при использовании асинхронной репликации главного подчиненного устройства
- Многолидерная репликация
- Стандартный шаблон распределения/миграции данных
- Введение в репликацию Mysql
- Обзор репликации бинарного лога (Binary Log File Position Based Replication)
- Обзор репликации с Глобальными Идентификаторами транзакции (Global transaction identifier (GTID) Based Replication)
- Допущения в статье
- Топология репликации
- Создание пользователя для репликации
- Пример настройки сервера mysql master-slave
- Получение координат бинарного лога с Мастер сервера
- Перенос данных MySQL с Мастер-сервера на реплику
- Создание копии данных MySQL с помощью mysqldump
- Создание копии данных MySQL с помощью сырых файлов
- Передача файлов на реплику
- Настройка slave сервера MySQL, при существующих данных в БД
- Добавление Slave сервера в существующее окружение репликации
- Multi-source репликация MySQL/MariaDB
- Репликация мастер-мастер (или круговая репликация)
- Переключение сервера MySQL из режима репликации в отдельный сервер (отключение репликации MySQL)
- Переключение мастер-сервера при отказах мастер-сервера (переключение на новый источник репликации)
- Рекомендации по резервному копированию в режиме MySQL репликации
- Диагностика репликации MySQL
- Основные шаги диагностики
- Краткий список действий
- Установка Percona Mysql Server
- Загрузка базы данных
- Настройка master — slave репликации
- Часто задаваемые вопросы по теме статьи (FAQ)
- Помогла статья? Подписывайся на telegram канал автора
Преимущества
Если данные, которые вы реплицируете, не меняются с течением времени, то процесс репликации является одноразовым. Частое изменение данных — настоящая проблема; это требует тщательного обдумывания параллелизма и всех вещей, которые могут пойти не так, чтобы мы могли справиться с последствиями этих ошибок. Как минимум, нам нужно иметь дело с недоступными узлами, прерываниями сети и незаметным повреждением данных из-за ошибок приложения.
Вот следующие алгоритмы для репликации изменений между узлами:
Репликация главный-подчиненный
Когда клиент хочет для чтения из базы данных он может запрашивать либо ведущее, либо любое из ведомых устройств. Однако записи принимаются только на мастере. Часто репликация на основе лидера конфигурируется как полностью асинхронная. В этом случае, если ведущее устройство выходит из строя и не подлежит восстановлению, любые записи, которые еще не были реплицированы на ведомые устройства, теряются. Это означает, что длительность записи не гарантируется. Снижение устойчивости — плохой компромисс.
Как мы можем придумать методы репликации, которые не теряют данные, но при этом обеспечивают хорошую производительность и доступность?
Обработка сбоев подчиненного узла
Любой узел в системе может выйти из строя из-за ошибки или перезагрузки в целях обслуживания. На своем локальном диске каждое ведомое устройство ведет журнал репликации изменений данных, полученных от ведущего устройства. Если ведомое устройство выходит из строя или перезапускается, оно может восстановиться из своего локального журнала, поскольку ему известна последняя транзакция, которая была обработана перед завершением работы. Как только ведомое устройство включено, оно подключается к ведущему и синхронизирует его там, где оно было отключено.
Обработка сбоев главного узла
Ошибка обработки главного узла — это сложнее. Теперь нам нужно обновить самое обновленное ведомое устройство в качестве нового ведущего и перенастроить логику для записи запросов на новый главный узел.
В случае полусинхронной репликации, мы делаем синхронное ведомое устройство новым ведущим, поскольку знаем, что он является наиболее обновленным и никакие данные не будут потеряны.
В случае асинхронной репликации есть некоторая вероятность, что новый мастер может не получить все записи от старого мастера (предположим, что он все еще не работает). Следовательно, эти изменения записи будут отменены, что может повлиять на другие прослушивающие приложения и конечных клиентов. У этой проблемы нет простых решений. По этой причине некоторые операционные группы предпочитают выполнять отработку отказа вручную. Итак, что лучше использовать репликацию с несколькими лидерами?
Общие сведения о журнале репликации
В простейшем случае лидер регистрирует каждый запрос записи ( оператор), который он выполняет, и отправляет этот журнал операторов своим последователям. Это означает, что для реляционной базы данных каждый оператор INSERT, UPDATE или DELETE пересылается последователям. Затем каждый последователь анализирует и выполняет этот оператор SQL, как если бы он был получен от клиента. На что следует обратить внимание:
Любой оператор, вызывающий недетерминированную функцию, например NOW () , для получения текущей даты и времени. или RAND () для получения случайного числа, скорее всего, для каждой реплики будет сгенерировано другое значение. Решение состоит в том, чтобы лидер заменил любые недетерминированные вызовы функций фиксированным возвращаемым значением, когда оператор регистрируется, чтобы все последователи получали одно и то же значение.
Использование в лучшем случае
Этот тип репликации требует, чтобы все операции записи выполнялись через один главный узел, но запросы только для чтения могут поступать на любые реплики. Для рабочих нагрузок, которые состоят в основном из чтения и лишь небольшого процента операций записи (распространенный шаблон в Интернете), есть привлекательный вариант создания множества последователей и распределения запросов на чтение между этими подписчиками. Это снимает нагрузку с лидера и позволяет запросам чтения обслуживаться ближайшими репликами.
Распространенные проблемы при использовании асинхронной репликации главного подчиненного устройства
Решение: при чтении чего-то, что пользователь, возможно, модифицировал, прочтите это у лидера; в противном случае прочтите это у подписчика. Это требует, чтобы у вас был способ узнать, было ли что-то изменено, не запрашивая его. Например, информацию профиля пользователя в социальной сети обычно может редактировать только владелец профиля, а не кто-либо другой. Таким образом, простое правило — всегда читать собственный профиль пользователя у лидера и читать профили других пользователей у фолловера.
Минусы: это увеличивает нагрузку на главный узел
Многолидерная репликация
Этот процесс репликации сложнее, чем главный-ведомый, но он проявляется, когда мы имеем дело с несколькими данными центров, потому что у вас может быть руководитель в каждом центре обработки данных. Каждый лидер отправляет свои записи каждому другому лидеру ( топология all-to-all это позволяет сообщениям перемещаться по разным путям, таким образом избегая единой точки сбой )
Стандартный шаблон распределения/миграции данных
Всем привет. Давненько я не писал. Сегодня будет лонгрид. Некоторое время назад стояла задача развернуть несколько серверов Mysql в конфигурации с репликацией базы данных и описать весь процесс. Данная инсталляция легла в основу статьи. Статья написана на основе официальной документации Mysql. По большей части, является структурированным переводом. Любые дополнения приветствуются. Поехали.
Введение в репликацию Mysql
Репликация позволяет копировать данные Вашей базы данных с одного сервера MySQL (источника) на другой сервер MySQL (реплику). По умолчанию, в MySQL репликация асинхронная. Это позволяет не держать постоянное подключение к серверу-источнику. В зависимости от конфигурации, реплицировать можно как все базы данных, так и выбранные, либо даже просто таблицы БД.
MySQL поддерживает различные методы репликации:
MySQL умеет различные типы/схемы синхронизации между источником и репликой:
Существуют три основных типа формата реплицируемых событий (переменная binlog_format):
Каждый из данных форматов имеет свои особенности, недостатки и достоинства. Эта тема для отдельной статьи.
Обзор репликации бинарного лога (Binary Log File Position Based Replication)
Каждая реплика получает полную копию бинарного лога и именно реплика отвечает за то, чтобы выполнить все (или не все, а только не/отфильтрованные или только для заданных таблиц/БД) запросы из полученного лог-файла.
Slave-сервер понимает откуда начать читать лог, исходя из заданных координат при настройке репликации:
Т.к. реплика хранит/сдвигает эти координаты в процессе прохождения по логу, реплика в любой момент может быть отключена от мастера и подключена снова. При этом, обработка лога продолжится с места на котором произошла остановка.
Резюмируя вышесказанное, а именно, наличие координат и возможность фильтровать/задавать таблицы и БД для чтения лога, позволяет подключить различные slave серверы к одному master и обрабатывать различные части исходной БД. Важно учитывать, что разработчики и приложения должны учитывать данные особенности, чтобы обеспечить консистентность данных/индексов/пр.
Обзор репликации с Глобальными Идентификаторами транзакции (Global transaction identifier (GTID) Based Replication)
GTID — это уникальный идентификатор, который создается и ассоциируется с каждой завершенной (commit) транзакцией на master сервере. Эта транзакция уникальна для всех серверов — участников репликации.
Таким образом, когда транзакция клиента выполнена (commit) и записана в бинарный лог на сервере-источнике, ей присваивается новый GTID. Каждый идентификатор GTID монотонно увеличивается, без промежутков в нумерации.
GTID представляет из себя пару координат, разделенных дветочием. Например:
GTID = source_id:transaction_id
или
GTID = 3E00FA47-22CA-01E1-9E33-C80UU9429452:23
, где
стоит знать, что в новых версиях MySQL/MariaDB формат GTID изменился и упростился
GTID сохраняется в телице БД mysql.gtid_executed только когда значение параметра gtid_mode — ON или ON_PERMISSIVE. Хотя , при включенном режиме gtid_mode, на мастер-сервере журналирование должно быть включено обязательно для возможности реплицировать завершенные транзакции, реплики могут работать без включения бинарного лога. Выключить бинарный лог можно, запустив сервер с опциями —skip-log-bin и —log-slave-updates=OFF
Допущения в статье
Т.к. статья сконцентрирована на репликации MySQL, я опустил некоторые моменты, чтобы сделать основную тему более понятной:
Топология репликации
server_id = 1
Этот параметр задает идентификатор сервера. Для всех серверов, которые включены в топологию репликации server_id должен быть установлен в диапазоне от 1 (по-умолчанию) до 4294967295 и он должен быть уникальным в рамках данной топологии. Значение параметра может быть изменено динамически командой mysql SET GLOBAL server_id = 2;. При этом, стоит знать, что если установить значение в ноль, то это отключит любые отношения репликации (отключит репликацию), изменение параметра в 0 требует перезагрузки/перезапуска сервера.
# на источнике
binlog_do_db = db_name
# на получателях/репликах
replicate_do_db = db_name
Необходимо задать базы данных, которые будут вовлечены (или исключены) в/из репликации. При старте репликации, реплика проверяет, есть ли база данных в параметрах —replicate-do-db или —replicate-ignore-db. Такой же параметр есть для мастера —binlog-do-db и —binlog-ignore-db. Поведение опций — как черные и белые списки. Опция -do- заставит сервер создавать бинарный лог только для баз данных из этой опции, опция -ignore- заставит сервер создавать бинарный лог для всех баз, кроме тех что указаны в опции.
log_bin = base_name_of_log
Примечание: В разных источниках в интернете есть небольшая путаница с log-bin параметром. Где-то он указан без аргумента, где-то с аргументом. Это происходит из-за разной интерпретации данного аргумента разными версиями MySQL/MariaDB. Старые версии рассматривают его только как включение бинарного лога, в новых версиях — значение этого параметра воспринимается как базовое имя фала бинарного лога.
Эта опция обязательна на мастере. На самом деле, в старых версиях MySQL требовалось задавать/включать параметр log_bin, но с версии ~5.6 он включен по умолчанию. Для выключения этой опции, необходимо при запуске сервиса указать параметр —skip-log-bin или —disable-log-bin. Как только эта опция указана, все запросы к БД (которые вносят изменения) логируются в бинарный лог. Если задан параметр как в примере, все имена файлов будут иметь вид:
На самом деле, есть еще одна опция, которая влияет на работу источника:
Создание пользователя для репликации
Каждая реплика подключается к мастеру с помощью MySQL пользователя и пароля. Соответственно, на каждом мастере должен быть создан пользователь, который может использоваться репликой для подключения. Если учетная запись создается только для репликации, она должна иметь привелегии REPLICATION SLAVE. Например, для создания нового пользователя replication, который будет подключаться с любого хоста в домене k-max.name, необходимо выполнить следующее:
Пример настройки сервера mysql master-slave
#/etc/mysql/my.cnf
server-id = 4
log_bin
replicate-do-db = db_name
Примечание! Slave сервер не обязан иметь включенную опцию log_bin. Однако, ее включение на реплике означает, что бинарные логи помогут серверу более стабильно работать при бэкапах, восстанавливать репликацию после сбоев и участвовать в более сложной топологии репликации в качестве мастера.
Получение координат бинарного лога с Мастер сервера
Следущий шаг — это получить информацию о том, откуда (с какого места, с какой транзакции) слейв-серверу начинать репликацию бинарного лога.
Пояснения к выводу команды: поле File показывает имя файла бинарного лога (обычно, в каталоге /var/lib/mysql/), Position показывает позицию в файле. Именно эти данные нужны для реплики.
Следующие шаги зависят от того, имеете ли Вы данные в БД на сервере-источнике:
Перенос данных MySQL с Мастер-сервера на реплику
Итак, если сервер-источник содержит данные, их можно перенести несколькими способами:
Создание копии данных MySQL с помощью mysqldump
Необходимо держать в уме, что при использовании опции —all-databases, будет перенесена база данный mysql, что на реплике приведет к переносу всех данных о пользователях. Соответственно, все пользователи при импорте будут заменены.
Создание копии данных MySQL с помощью сырых файлов
Итак, данный способ должен учитывать соблюдение дополнительных требований:
Следующие файлы не нужны для репликации и могут бы исключены:
Передача файлов на реплику
Повторюсь еще раз, этот метод приемлем только, если Вы устанавливаете репликацию с нового (чистого) MySQL сервера. И после запуска репликации Вы можете импортировать данные дампов в мастер. Таким образом, т.к. импорт будет осуществляться при установленной репликации, импортированные дампы будут скопированы (реплицированы) на реплику автоматически.
Список шагов следующий:
Указывать координаты, когда настраивается репликация с чистого мастера не нужно.
master1# mysql < fulldb.dump
Проверить статус репликации можно в выводе команд SHOW REPLICA STATUSG (mysql новее 8. X) или SHOW SLAVE STATUSG (старые версии mysql) в значениях SQL thread and replication I/O thread.
Настройка slave сервера MySQL, при существующих данных в БД
На что нужно обратить внимание:
Если сервер-источник имеет любые запланированные события в шедулере, необходимо убедиться, что эти события не буду запущены на реплике после импорта данных. Event Scheduler управляется переменной event_scheduler, которая по умолчанию — ON с версии MySQl 8.0. Тем самым, запланированные события запустятся при запуске реплики после импорта данных. Это вызовет ошибки. Чтобы отключить все события, необходимо перед импортом установить эту переменную в OFF DISABLED командой SET event_scheduler = ‘OFF’;
После проделанных шагов, slave сервер подключится к master серверу и начнет реплицировать любые обновления произошедшие на сервере-источнике с момента создания снапшота. ошибки репликации так же можно отслеживать в error.log MySQL сервера.
Снапшот, который мы получили с мастера может быть применен к любому количеству реплик. То есть можно настроить репликацию один-ко-многим с использованием единого дампа MySQl, просто повторив шаги данного раздела.
Добавление Slave сервера в существующее окружение репликации
Можно легко добавить новую реплику в существующую топологию репликации без остановки мастер-сервера. Для этого можно просто остановить существующую реплику, скопировать каталог данных MySQL на новый сервер и задать новый ID и UUID сервера.
Добавление нового Slave сервера в существующее окружение репликации Mysql по шагам:
Multi-source репликация MySQL/MariaDB
При настройке репликации MySQL из нескольких источников (т.н. F AN-IN репликация), Slave сервер может быть настроен несколькими способами:
Я опишу второй путь, т.к. первый не отличается от настройки обычной репликации. Итак, вспомним, что в нашей топологии есть 3 ключевых сервера:
Два сервера-источника: master1(Master/Source/10.0.2.2) и slave1(Slave/Replica/10.0.2.4) (это slave, на котором включен бинарный лог, так что он может быть и мастером)
Один реплика-сервер:slave2(Second Slave/Replica/10.0.2.5).
Реплика-сервер будет реплицировать две базы данных: test с master1 и test_s1 с slave1.
Итак, шаги настройки такие:
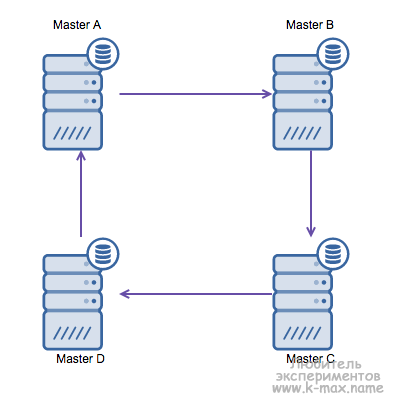
Репликация мастер-мастер (или круговая репликация)
Настройка репликации MySQL в режиме мастер-мастер подразумевает то, что в случае отказа одного из серверов — другие участники репликации прозрачно подхватят работу. То есть не нужно будет делать ручных шагов для перевода сервера роли Slave-сервера в Master (что вызовет перерыв сервиса). Круговая репликация (или circular replication) MySQL может быть использована для масштабирования MySQL нодов, доступных на запись (изменение базы данных). ! Но есть нюансы. В данной конфигурации, MySQL не выполняет разрешение конфликтов, то есть нет реализованного протокола, который отслеживает блокировки таблицбаз между нодами. То есть, например, если мы используем внешние ключи (FOREIGN KEY) в нашей базе данных INSERT может завершится ошибкой, если ссылка на внешний ключ не успела реплицироваться.
Master-master репликация между двумя нодами

Master-master репликация между четырьмя нодами
Настройка MySQL сервера для мастер-мастер репликации на самом деле — это просто настройка мастер-слэйв репликации много раз от одной ноды к другой по кругу. Самый простой пример такой репликации — репликация между двумя нодами. Репликация настраивается в две стороны: от первой ноде ко второй и от второй ноды — к первой. Рассмотрим пример настройки репликации между master1 и master2.
Важный нюанс, на который стоит обратить внимание — это параметры auto_increment_increment и auto_increment_offset которые помогают защитить от перехлеста автоматически возрастающих индексов.
Переключение сервера MySQL из режима репликации в отдельный сервер (отключение репликации MySQL)
Если установить server ID в ноль, то бинарный лог продолжит работать, но в режиме server_id = 0 сервер MySQL отбрасывает любые подключения от реплик. так же, реплика с server_id = 0 не пытается установить соединения с мастером. Стоит помнить, что этот параметр может быть изменен на работающем сервере, но изменения будут приняты только после рестарта MySQL!
Переключение мастер-сервера при отказах мастер-сервера (переключение на новый источник репликации)
Ок. Давайте посмотрим на исходную топологию репликации:

Топология репликации MySQL до сбоя
Предположим, что мастер сервер умер и недоступен. Давайте сделаем нашу реплику1 новым мастером и получим следующую топологию репликации:

Для назначение нового мастер-сервера, необходимо выбрать реплику, которая станет новым мастером. В нашем случае — это Replica1. А оставшимся (2 и 3) необходимо просто запустить команды CHANGE REPLICATION SOURCE TO (from MySQL 8.0.23) или CHANGE MASTER TO с необходимыми параметрами. Все, реплика просто начнет читать бинарный лог с нового источника, выполнять запросы на своих базах данных и не будет проверять, совместима ли база данных на источнике.
Новый мастер сервер (который Replica1) желательно запустить с параметром —log-slave-updates=OFF или изменить его онлайн.
Так же, необходимо не забыть про клиентов — они должны быть перенаправлены на нового мастера, который теперь Replica1. Часто, для этого используют такое решения, как демон keepalived.
Итак, давайте пройдемся по шагам:
Более подробно — тут
Рекомендации по резервному копированию в режиме MySQL репликации
Резервное копирование и восстановление в режиме репликации использует те же принципы, что и отдельный (standalone) MySQL сервер. Резервное копирование может быть логическим (например, с помощью утилиты mysqldump) или физическим (копирование каталога данных /var/lib/mysql). mysqldump имеет опцию —single-transaction, которая создает образ и позволяет избежать блокирования работы других клиентов.
Копию базы данных возможно получать как с мастер-сервера, так и с реплики. Поэтому очень часто репликацию используют для аккумулирования всех баз на одном slave сервере и в едином месте делают логические копии и архивацию.
Есть так же рекомендация для бОльшей надежности и консистентности резервной копии — использовать переменную read_only и выполнять резервное копирование в следующей последовательности:
Диагностика репликации MySQL
Ошибка Last_IO_Error equal MySQL server UUIDs
Last_IO_Error: Fatal error: The slave I/O thread stops because master and slave have equal MySQL server UUIDs; these UUIDs must be different for replication to work.
Ошибка может появляться, если вы перенесли каталог данных MySQL на новый сервер и запустили сервер со старым файлом auto.cnf. Для устранения ошибки — необходимо удалить файл и при следующем запуске сервер сгенерирует новый UUID.
Ошибка MY-010584 — MY-002061
а так же
Ошибка возникает при подключении реплики к мастер-серверу более старой/новой версии. Для устранения — необходимо корректно настроить шифрование или использовать mysql_native_password в качестве плагина при создании пользователя репликации. подробнее тут
Ошибка возникает при переносе (импорте) базы данных с мастер-сервера на реплику. Для устранения — необходимо задать новое имя файла в параметрах relay-log и relay-log-index.
Основные шаги диагностики
Теги: MySQL, настройка
В данной статье хочу затронуть актуальную тему эксплуатации популярного сервера баз данных. Я расскажу, как настроить репликацию master — slave на примере Mysql сервера Percona. Это не пример настройки отказоустойчивой системы. Создается именно актуальная копия базы данных для различных нужд (бэкап, тестирование, тяжелые выборки и т.д.).
За основу я возьму 2 виртуальные машины на базе Centos 8. Если у вас их еще нет, можете воспользоваться моими статьями на тему установки и базовой настройки Centos 8. Ниже небольшая таблица, чтобы дальше было проще ориентироваться в статье.
Начнем настройку репликации с установки Mysql сервера на обе виртуальные машины. Ниже приведу краткий список действий, чтобы сразу было понятно, что мы будем делать.
Краткий список действий
Настройка master-slave репликации mysql.
Установка Percona Mysql Server
Установить percona mysql server не представляет никакой сложности, так как есть репозиторий с готовыми пакетами под все популярные системы, в том числе под centos. Подключаем этот репозиторий. Действия выполняем одновременно на обоих серверах.
# dnf install https://repo.percona.com/yum/percona-release-latest.noarch.rpm
Отключаем стандартный модуль mysql и активируем репозиторий перконы.
# dnf module disable mysql
# percona-release setup ps80
Устанавливаем Percona Mysql Server на Centos 8. Заодно поставим xstrabackup и другие утилиты, которые нам могут понадобиться в процессе эксплуатации.
# dnf install percona-server-server percona-toolkit percona-xtrabackup-80
После установки запускаем mysql сервер и добавляем в автозагрузку.
# systemctl enable —now mysqld
Во время установки был автоматически сгенерирован временный пароль root. Посмотреть его можно в логе /var/log/mysqld.log.
Используя этот пароль, выполним начальную настройку сервера, удалив все лишнее и указав свой пароль. Имейте ввиду, что по умолчанию установлен Password Validation Plugin, который не позволит вам создать простой пароль. Он должен удовлетворять следующим требованиям:
Убедитесь, что вы запомнили свой новый пароль и можете подключаться, используя его.
Серверы Mysql установили на обоих виртуальных машинах. Двигаемся дальше.
Загрузка базы данных
Загрузим теперь на оба наших сервера дампы базы данных, которую он будет обслуживать. Если вы начинаете новую базу с нуля, то просто создайте ее на обоих серверах. Я же загружу из архива, сделанного с помощью mysqldump, базу своего сайта.
Теперь создадим на мастере учетную запись, от имени которой будет работать репликация. Напоминаю, что 10.20.1.29 — ip адрес для slave сервера.
Настройка master — slave репликации
У нас все готово для настройки непосредственно репликации. Но перед тем, как ее начать, убедитесь, что у вас настроен или отключен firewalld. В общем случае на мастере разрешите подключаться к серверу по tcp порту 3306, на котором работает mysql сервер.
# firewall-cmd —permanent —add-port=3306/tcp
# firewall-cmd —reload
Теперь запускаем репликацию. Для этого идем на мастер и смотрим master log position в консоли mysql.
Переходим на slave и выполняем в консоли mysql.
Проверяем статус репликации.
Скорее всего вы увидите ошибку:
Суть ее в том, что в версии Mysql 8 поменялся плагин для аутентификации с mysql_native_password на caching_sha2_password. Теперь для корректной работы репликации необходимо настраивать подключение с использованием tls сертификатов. Если инфраструктура закрытая и данные передаются не через интернет, то этим можно пренебречь. К примеру, я всегда настраиваю vpn тоннель, если репликация работает через интернет.
Самый простой способ исправить ошибку, это зашифровать пароль пользователя предыдущим плагином. Делается это так.
После этого вернитесь на slave, остановите репликацию, обновите информацию с мастера и запустите заново. Ошибки быть не должно.
Проверьте теперь статус репликации. Признаком того, что все в порядке, будет отсутствие ошибок и информация в следующих строках.
Slave_IO_State: Waiting for master to send event
Slave_IO_Running: Yes
Slave_SQL_Running: Yes
Seconds_Behind_Master: 0
Если репликация идет нормально, slave будет идти за master. Номер лога Master_Log_File и позиция Exec_Master_Log_Pos будут расти. Если значение Slave_IO_State пусто или Connecting to master, а Seconds_Behind_Master равно NULL, репликация не началась.
Дальше можете проверять работу репликации. Так как у нас настроена репликация всей информации, можете создать на мастере новую базу данных и добавить в нее какие-то значения.
Теперь идем на реплику и проверяем, получила ли она изменения.
Все в порядке, репликация работает. Можно настроить ее мониторинг. Для бэкапа данных с реплики рекомендую использовать percona xtrabackup.
Часто задаваемые вопросы по теме статьи (FAQ)
Есть ли отличия в настройке репликации master slave в других форках mysql, например mariadb?
Нет. Описанный мной способ подходит для настройки репликации во всех популярных версиях серверов mysql.
Как следует добавлять дополнительные slave серверы, если возникнет такая необходимость?
Никакой разницы нет, будет ли у вас один slave сервер или несколько. Добавление следующих серверов происходит точно так же, как и первого. Настраиваете slave сервер, заливаете дамп баз и запускаете репликацию.
Что следует сделать, чтобы вернуть репликацию, если slave сервер потеряет связь с мастером?
Ничего особенного делать не надо. Если связь с мастером прервалась и репликация остановилась, достаточно восстановить связь и запустить заново репликацию. Slave сервер подтянет все изменения с мастера.
Вот так относительно просто настраивается обычная master — slave репликация mysql. Подобным же образом настраивается и master-master репликация, но на практике она очень нестабильно работает. Я пробовал в свое время, но в итоге отказался, так как надоело ее чинить и исправлять ошибки. Для полноценного кластера с мультизаписью лучше использовать какие-то специализированные решения типа Percona XtraDB Cluster.
Кстати, он же может заменить и текущую конфигурацию, если сделать его из двух нод и писать только в одну. Разрешив ему работать при выходе из строя реплики, получится примерно то же самое, что и в статье. Но смысла в этом особо нет, так как предложенная мной конфигурация настраивается проще и быстрее. Плюс, это типовое решение для любого mysql сервера.
Помогла статья? Подписывайся на telegram канал автора
Анонсы всех статей, плюс много другой полезной и интересной информации, которая не попадает на сайт.